


奥尔特曼谈下一代GPT:约1万个智能体曾协同攻关数学难题
产联社编辑 | 黄钰慧
图片由AI生成
【产联社】OpenAI正在拓展多智能体协作的应用场景。当地时间11月2日,在阿布扎比举行的ADIPEC 2026能源大会上,OpenAI首席执行官萨姆·奥尔特曼(Sam Altman)透露,此前参与纳维—斯托克斯数学问题研究的,是约1万个由即将发布的下一代GPT驱动的AI智能体(Agent)。这些智能体连续协作约4天,共同推进了一项长期困扰数学界的研究任务。
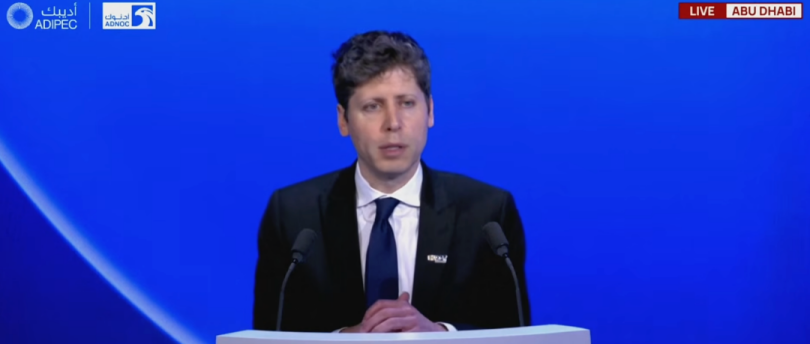
奥尔特曼表示,这些智能体之间没有传统的管理层级,也没有统一的负责人,而是能够自主探索研究方向、分享进展,并根据其他智能体的发现调整工作。奥尔特曼将其视为AI发展过程中令人印象深刻的时刻之一。
奥尔特曼此次披露的研究成果并非首次公开。9月8日,OpenAI曾发布纳维—斯托克斯问题的证明论文及机器验证文件,并表示完成研究的内部模型能力显著超过GPT-6 Astra。
此次奥尔特曼进一步确认,参与研究的模型正是即将发布的下一代GPT。不过,OpenAI尚未公布其正式型号、具体发布时间及对外开放方式。
OpenAI此次实验进一步展示了多智能体协同解决复杂问题的能力,也为AI参与长期科研和工程任务提供了新的技术案例。
万级Agent如何完成数学攻关
OpenAI的数学实验展示了多智能体协同处理复杂研究任务的具体过程。
此次研究围绕纳维—斯托克斯方程展开。这组方程用于描述水、空气等流体的运动规律,广泛应用于航空设计、天气预测等领域。
其中一个长期未解决的问题是,原本平滑的三维流体运动,是否可能在有限时间内出现数学意义上的异常变化。
2000年,克雷数学研究所将其列入七大千禧年数学难题,并为每道难题设立100万美元奖金。
9月8日,OpenAI宣布,其内部系统生成了一份数学证明,表明在施加平滑外力、总能量保持有限的条件下,原本静止且运动状态平滑的流体,可以在有限时间内出现奇点。OpenAI同步公布了相关论文及Lean形式化证明文件。
9月11日,克雷数学研究所回应称,相关成果看起来可能解决了这一长期难题,但仍需按照既定程序进行评估。OpenAI也明确表示,无意凭借该成果申领千禧年大奖。
OpenAI披露,整个实验始于9月1日。研究人员将不同数学问题及其证明方向分配给多个智能体小组,让它们并行开展探索。
与传统聊天机器人主要根据用户提问生成回复不同,这些智能体可以读取缓存的互联网资料、运行代码,并在小组内部交流研究结果。
研究最初并未集中于纳维—斯托克斯问题。OpenAI同时安排智能体探索其他数学难题,其中约100个智能体经过约50小时协作,在相关的欧拉方程问题上取得进展。
研究人员随后将更多计算资源转向纳维—斯托克斯问题,并把此前获得的成果提供给其他智能体作为研究线索。
在后续实验中,OpenAI还使用Codex整理不同智能体小组的发现,将有价值的思路重新反馈给研究系统。参与研究的内部模型也在实验期间完成进一步训练升级。
根据OpenAI公布的数据,最终找到相关解法的小组包含约1万个并发智能体。从首批智能体启动到9月5日得出研究结果,历时约88小时。
其间,参与纳维—斯托克斯研究的智能体累计发送约270万条消息,生成约1300亿个输出Token。此后,OpenAI又使用GPT-6 Astra花费17小时完成Lean形式化验证。
整个过程并非完全没有人工参与。OpenAI研究人员负责调整计算资源、提供新的研究线索,并利用工具汇总不同小组的成果。
不过,具体证明思路的探索和大量推导工作由智能体承担,显示出AI在复杂科研任务中的自主执行能力。
下一代GPT能力有何变化
OpenAI正在通过持续训练和复杂任务测试,提高内部模型的科研推理能力。
9月8日,OpenAI首次披露,参与数学研究的内部模型能力显著超过GPT-6 Astra。该公司表示,自8月28日起,其一直在训练一款新的内部模型,并在包括数学在内的多项基准测试中取得此前未达到的成绩。随着训练继续推进,模型的能力也在持续提升。
从技术进展看,下一代GPT的提升主要体现在两个方面:一方面,模型能够处理难度更高、需要连续推导的研究问题;另一方面,多个由同一模型驱动的智能体可以同时探索不同方案,并根据其他小组的成果继续推进任务。
OpenAI的内部模型随后展示了更多数学研究成果。
9月21日,OpenAI进一步披露,其内部模型已在数学多个领域的100多个长期未解决问题上取得研究成果。
OpenAI表示,模型进展的速度超出了公司内部数学研究人员的预期,也促使其开始讨论如何向学术界披露这些成果,以及如何负责任地开放相关能力。
同日,OpenAI表示,正与一个由数学家组成、独立于公司的咨询小组合作,就研究成果的评议、发布及学术规范等提供建议。
奥尔特曼11月2日的发言,则进一步将此前的内部研究成果与即将发布的GPT产品联系起来。下一代GPT是否会直接提供万级智能体协作功能、如何向开发者开放,以及与现有GPT产品之间有哪些具体差别,目前仍有待公布。
多智能体协作走向实际应用
OpenAI正在探索将复杂任务处理能力从科研实验延伸到企业运营和工程场景。
在传统AI应用中,用户通常需要逐步提出问题、检查结果,并决定下一步操作。多智能体协作则提供了另一种可能:将一项复杂工作拆分为多个任务,由不同智能体分别执行,再汇总结果。
例如,在科研研发中,不同智能体可以分别检索资料、设计方案、运行计算和检查结果;在软件开发中,也可以分别承担代码编写、测试和问题排查等工作。
这些场景与OpenAI数学实验展示的任务分工方式具有相似之处,但其实际效果仍取决于模型可靠性、工具能力和业务要求。
在企业落地方面,OpenAI已经开始推进相关合作。
11月2日,阿布扎比国家石油公司(ADNOC)宣布与OpenAI、阿布扎比科技集团G42达成多年合作协议,计划引入OpenAI Frontier平台,推动不同AI智能体协同处理能源企业的复杂业务任务。
根据ADNOC公告,合作将使用部署在阿联酋本地计算基础设施上的GPT模型,通过相互连接的AI智能体,协助评估生产、加工、炼化、物流及销售交易等环节的决策影响。
ADNOC表示,合作初期将重点应用于油田总体规划,整合数千口油井、多个油藏及数百个地面设施积累的数据,支持复杂开发方案的制定和优化。
按照公司提出的目标,相关工作有望从过去需要数月缩短至数小时。ADNOC同时强调,企业专家仍将对重大决策保留监督权。
ADNOC的合作属于企业业务应用,不代表下一代GPT或此前实验中的万级Agent系统已经正式部署。但从应用方向看,OpenAI正在推动智能体参与跨部门、跨流程的复杂工作,而不再仅限于单一的信息查询或文本生成任务。
算力成本仍是落地关键
大规模智能体协作在展示更强任务处理能力的同时,也带来了高昂的计算成本。
10月29日,在与Stripe联合创始人约翰·科里森(John Collison)的播客对话中,奥尔特曼透露,OpenAI在纳维—斯托克斯问题研究上的投入约为1000万美元,实际支出可能略高。
这一数字反映出复杂AI科研任务对计算资源的需求。多个智能体长时间并行工作,需要不断生成和处理信息,还要调用工具、反复尝试不同方案。随着智能体数量和任务复杂程度增加,计算消耗也可能持续上升。
不过,奥尔特曼认为,相关成本有望快速下降。
他预测,在完成这项研究约一年后,凭借更强的模型和改进的方法,重做纳维—斯托克斯研究的成本可能降至原来的1%。
如果以1000万美元作为参考,未来完成类似工作的成本可能降至约10万美元。
除计算成本外,能源供应也成为AI发展的重要制约因素。
在11月2日ADIPEC大会上,当被问及当前面临的最大挑战时,奥尔特曼直接回答“能源”。他表示,虽然单次AI请求所需的能源已经下降,但随着AI使用需求快速增长,整体电力需求仍在上升。
奥尔特曼还举例称,六年前,OpenAI内部Token使用量最高的员工每月消耗约10万个Token,而如今最高使用者的月消耗量已经达到约5000亿个Token。
在奥尔特曼看来,AI模型效率还可以继续提高,但电力和物理基础设施的扩张无法完全依靠软件优化完成。
随着模型能力提升和智能体应用增加,算力基础设施与能源供应将继续影响AI技术的使用规模。
OpenAI尚未公布下一代GPT的正式发布时间及商业化方案。对于企业而言,模型能否在真实业务中稳定执行复杂任务,以及多智能体协作的成本能否降至可持续使用的水平,将是后续技术落地的重要观察指标。
(扫码加入AI产业交流群)
商务合作,请联系侯经理 18801065284(微信同号)
报料及内容合作,请联系chanlianshe2026(微信号)
特别声明:本文仅供参考,不构成任何投资建议,未经允许不得转载。