


谷歌发布Gemini 4 Carbon 主攻复杂工程和网络安全
产联社编辑 | 黄钰慧
图片由AI生成
【产联社】谷歌把新一轮模型升级的重点放在了复杂工程任务上。北京时间10月29日凌晨,谷歌宣布推出Gemini 4 Carbon,称内部团队已观察到它连续运行数天,在大型软件项目中追查故障原因并修补代码。
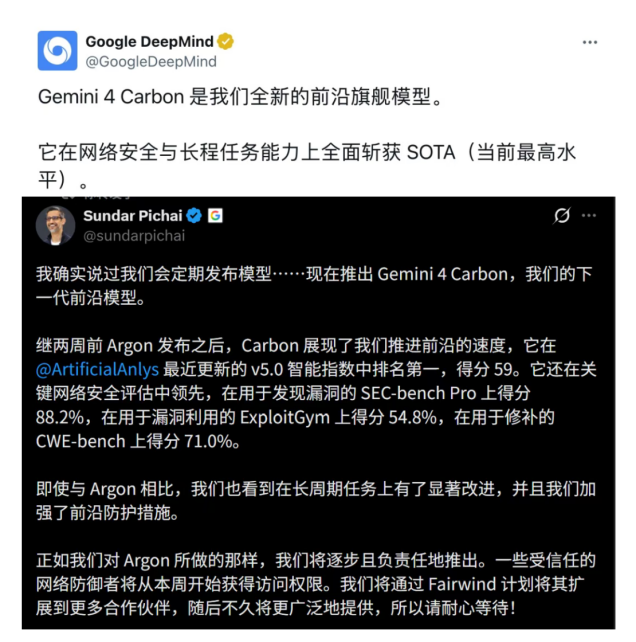
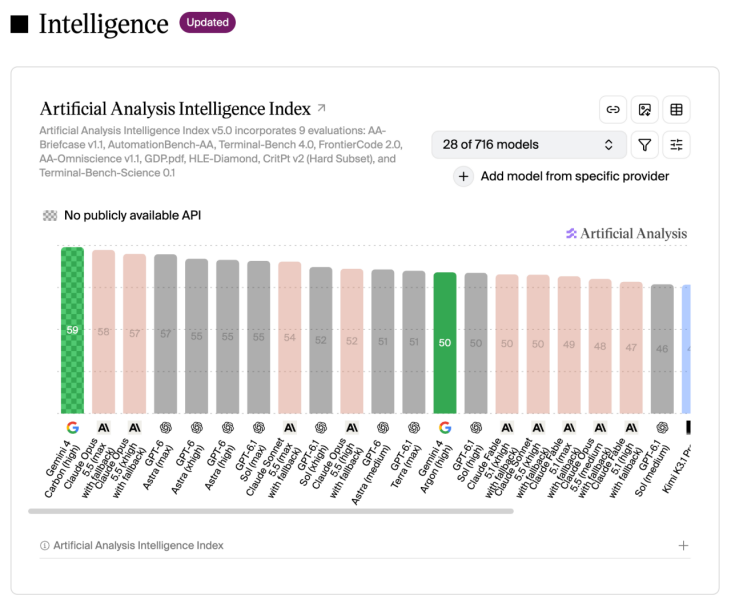
第三方评测机构Artificial Analysis公布,Carbon登上其综合智能指数v5榜首,但在编程和知识工作等具体任务中,仍有其他模型取得更高成绩。
从写代码走向持续解决问题
此次更新的一项重点,是让模型在任务遇阻后继续寻找解决办法。谷歌称,Carbon能够在复杂工程任务中尝试不同路径,处理大型代码库和底层系统中难以发现的问题。
按照谷歌描述的内部使用场景,Carbon承担的工作已从生成代码,延伸到寻找故障根因、修改代码等相互衔接的步骤。
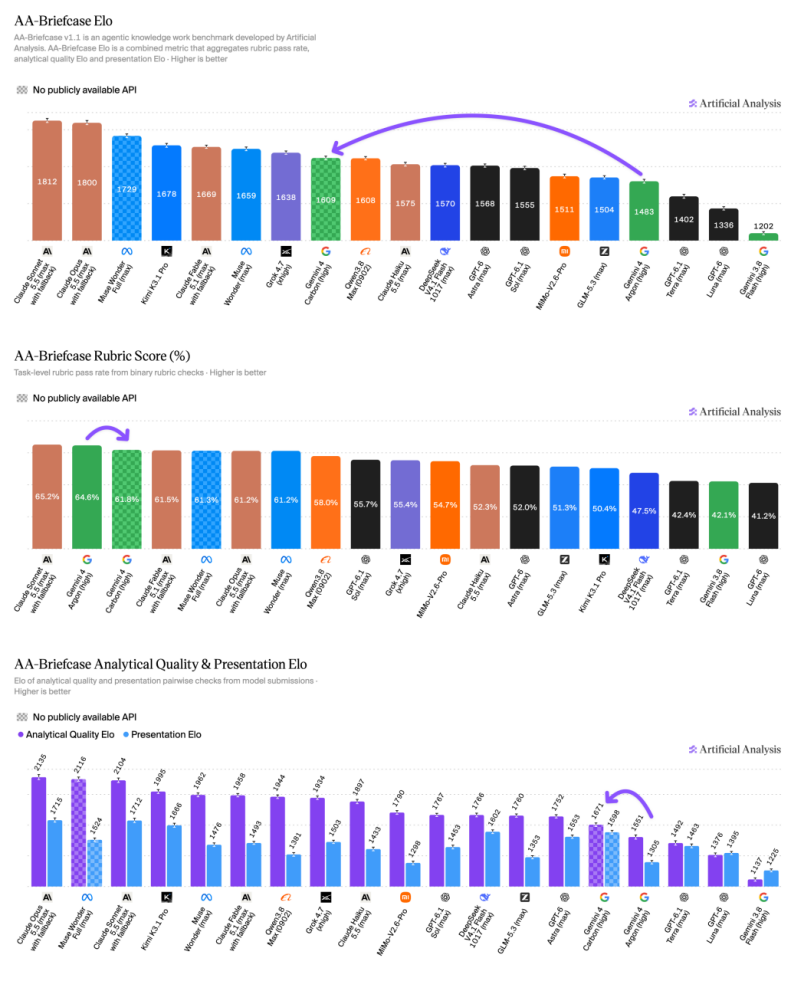
除了编程,Carbon处理知识工作任务的表现也有改善。Artificial Analysis称,与前代Argon相比,新模型在分析质量和成果呈现质量上均有提升,不过在AA-Briefcase知识工作评测中,仍落后于Kimi K3.1 Pro等模型。
找漏洞之外,还要验证风险
网络安全是谷歌此次集中展示的应用方向。公司公布的测试覆盖三个相连的环节,即发现软件漏洞、验证漏洞能否被利用,以及修复问题。谷歌公布的结果显示,Carbon在上述三类测试中的成绩均高于Argon。
模型执行任务时是否会编造信息、擅自扩大操作范围,也是此次改进内容。谷歌称,在内部测试中,Carbon缺乏依据的陈述较Argon减少约一半,超出任务范围的行为减少26%。
不过,第三方测试并未证明所有可靠性指标都同步改善。Artificial Analysis发现,Carbon在一项知识测试中答对的题目更多了,但该项测试的幻觉率也有所上升。
综合成绩登顶,编程能力仍在追赶
Carbon在综合排名上领先,编程任务的成绩则有升有降。在Artificial Analysis智能指数v5中,Carbon获得59分,高于前代Argon的50分,也超过Claude Opus 5.5的58分。
具体到编程工具,Carbon搭配谷歌Antigravity后的评测成绩,比Argon搭配同款工具提高6分,但仍落后于Claude Code搭配Opus 5.5。
不同编程任务中的表现也有差别。在考查真实软件项目代码修改能力的测试中,Carbon得分约41%,较Argon的26%明显提高,但仍低于Opus 5.5的46%。 在考查编程和终端操作的另一项测试中,Carbon约为65%,则高于Opus 5.5的60%。
单价延续优惠,企业接入仍需等待
Carbon沿用了Argon的首发优惠价。每百万输入token收费2美元、输出10美元;优惠期结束后,分别调整为4美元和20美元,优惠结束日期尚未明确。
完成一项工作的费用,还要结合实际用量来看。按标准价格计算,Artificial Analysis测得Carbon每项智能指数任务的加权平均成本为7.76美元,低于Opus 5.5的10.04美元,但高于GPT-6 Astra的6.25美元,这一比较仅对应其评测任务。
开放安排上,谷歌宣布先向部分网络安全防御人员提供Carbon,再通过Fairwind计划逐步扩大至更多可信合作伙伴,并在收集反馈、完善防护措施后,向开发者、企业和消费者提供,具体日期尚未公布。
此次更新中,谷歌重点展示了Carbon持续排查软件问题、验证风险和修补漏洞的能力。对企业来说,更值得关注的是它能否减少返工、节省时间,以及完成一项工作的实际开销。这些问题,仍需在具体业务中检验。
商务合作,请联系侯经理 18801065284(微信同号)
报料及内容合作,请联系chanlianshe2026(微信号)
特别声明:本文仅供参考,不构成任何投资建议,未经允许不得转载。