


MiniMax M3.1 Flash正式开源 上线72小时处理超100万亿Token
产联社编辑 | 黄钰慧
图片由AI生成
【产联社】MiniMax新一代大模型M3.1 Flash正式开源。10月23日,MiniMax宣布开放M3.1 Flash模型权重,并披露该模型自10月19日上线后,72小时内真实用户处理的Token数量超过100万亿。MiniMax同时联合华为昇腾、平头哥、昆仑芯、摩尔线程、NVIDIA、AMD等国内外芯片厂商,以及多家云服务和推理平台,共同推进模型开源首日接入。
10月19日,MiniMax发布M3.1 Flash,宣布新模型线上推理速度较前代提升近3倍,Agent任务综合使用成本降低70%。随着模型权重开放,开发者可在满足许可及硬件要求的前提下,探索通过第三方平台或自有计算环境部署模型。
上线72小时处理超100万亿Token
M3.1 Flash正式发布前,早期版本已通过匿名测试积累了大量使用数据。10月19日,MiniMax确认,此前以Space Bunny名称运行的匿名模型,正是M3.1 Flash的早期版本,匿名运行期间累计处理超过200万亿Token。与10月23日披露的上线72小时超100万亿Token不同,Space Bunny的数据统计的是早期版本匿名运行期间的累计处理量,两者不能直接比较增幅。
在模型规模方面,M3.1 Flash采用混合专家架构(MoE),总参数量为4280亿,每个Token的激活参数量约为230亿。这意味着,模型不必每次都调用全部参数参与计算,从而减少计算量,提高运行效率。
目前,M3.1 Flash的开源地址已对外公布,包括Hugging Face和魔搭ModelScope两大模型社区。与仅开放API相比,公开模型权重使开发者能够进一步研究模型的运行方式,并在满足许可条件及硬件要求的前提下,选择适合自身业务的部署环境。
推理速度提升近3倍,Agent任务成本下降70%
与前代M3相比,M3.1 Flash在推理速度和使用成本两方面均有改善,MiniMax同时重点升级了模型处理复杂Agent任务的能力。
10月19日,MiniMax发布M3.1 Flash时表示,新模型线上推理速度较前代提升近3倍。在日常使用场景下,模型输出速度可达到每秒200个Token以上,中位数输出速度稳定在每秒170个Token以上。对于需要长时间运行、反复调用模型的Agent任务而言,更快的生成速度有助于减少执行过程中的等待时间。
价格方面,MiniMax公布的国内API定价为每百万Token输入1元、输出4元、缓存读取0.1元。与上一代M3相比,M3.1 Flash的API价格明显下降。
财新10月20日报道指出,前代M3模型按输入长度分档收费,较低档位每百万Token输入2.1元、输出8.4元;当输入超过512K Token时,价格进一步提高至输入4.2元、输出16.8元。相比之下,M3.1 Flash采用统一定价,每百万Token输入1元、输出4元。
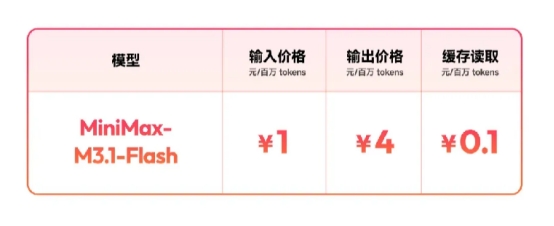
MiniMax还表示,在Agent任务中,M3.1 Flash的综合使用成本较前代降低70%。这一数字并非所有API单价统一下降70%,而是公司针对Agent任务公布的整体成本变化。
对于需要反复读取资料、调用工具和执行多个操作步骤的企业应用,除了单次调用价格,完成整个任务需要消耗多少Token,同样会影响最终成本。
在模型能力方面,MiniMax重点提升了复杂Agent任务、编程、Computer Use及网络安全能力。与主要回答问题的聊天模式相比,Agent更强调执行任务。例如,企业使用AI处理业务时,模型可能需要连续完成信息检索、文件读取、软件操作等步骤,而不只是生成文字答案。
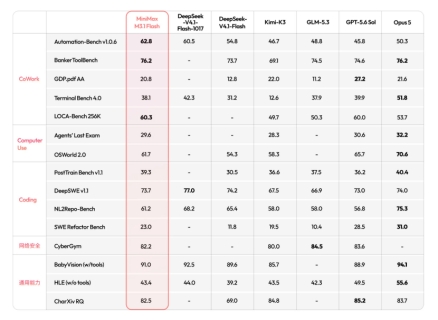
根据MiniMax公布的测试结果,M3.1 Flash在评估企业自动化任务的AutomationBench-AA中位居前列,在面向金融业务工具调用的BankerToolBench测试中获得76.2分。后者重点考察模型完成多步骤任务、保持不同文档信息一致,以及连续调用工具等能力。MiniMax还披露,模型在DeepSWE v1.1软件开发测试中取得73.7%的成绩,在OSWorld V2电脑操作测试中获得61.7分。
上述成绩均为MiniMax公布的基准测试结果。模型在实际企业业务中的表现,还取决于具体任务、外部系统和数据环境,不能直接以测试分数衡量实际业务完成率。
联合国内外芯片厂商推进接入
M3.1 Flash正式开源后,MiniMax同步公布了覆盖芯片、云服务、推理框架和开源社区的合作阵容,推动模型在不同计算环境中运行。
10月23日,MiniMax宣布携手华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数、NVIDIA、AMD等国内外芯片厂商,共同推进M3.1 Flash的开源首日接入。这份名单既包括国内AI芯片企业,也覆盖国际GPU厂商。对开发者而言,不同芯片平台的适配支持,有助于扩大模型的潜在部署范围。
推理和云服务方面,MiniMax还宣布与Together AI、Fireworks、Nebius、Baseten、Modal、DigitalOcean等平台推进合作。同时,vLLM、SGLang、智源FlagOS等推理框架,以及Hugging Face、魔搭等开源社区,也将参与推动M3.1 Flash在不同硬件和开发环境中的应用。
芯片适配是开源模型投入实际使用的重要环节。模型权重公开后,开发者还需要相应的硬件、推理框架和部署工具支持,才能在不同计算平台上运行。对于企业而言,适配平台越丰富,可评估的部署方案也越多,既可以继续使用官方API,也可以选择第三方云服务,或在条件允许时自行部署。
MiniMax此次宣布的是与相关厂商及平台共同推进首日接入,不能据此认定所有合作方均已完成适配、开放正式服务或实现商业部署。各平台的实际支持情况仍需以其发布的产品公告和技术文档为准。
不同部署方式在成本和管理要求上存在差别。通过API调用通常不需要自行维护模型运行环境,而自行部署则需要承担算力、运维和系统集成等投入。因此,企业选择部署方式时,仍需结合调用规模、实际任务完成率和整体使用成本进行评估。
随着M3.1 Flash正式开放权重,MiniMax正进一步推动模型在不同计算平台上的部署。对于企业而言,除了官方公布的速度、价格和性能指标,不同硬件平台的适配进展及模型在实际业务中的运行效果,将是后续评估的重要依据。
商务合作,请联系侯经理 18801065284(微信同号)
报料及内容合作,请联系chanlianshe2026(微信号)
特别声明:本文仅供参考,不构成任何投资建议,未经允许不得转载。