


【实战派】当模型越来越便宜,什么才开始值钱?
独家专栏作者 刘敏
(刘敏(Allen Liu),现任SVTR 硅谷科技评论创始人、AI 与基础设施投资人。拥有逾 10 年创投及科技行业经验,曾任职于 AWS、元禾原点、平安资本,累计主导及管理投资超过 10 亿美元,聚焦 AI、机器人与前沿科技)
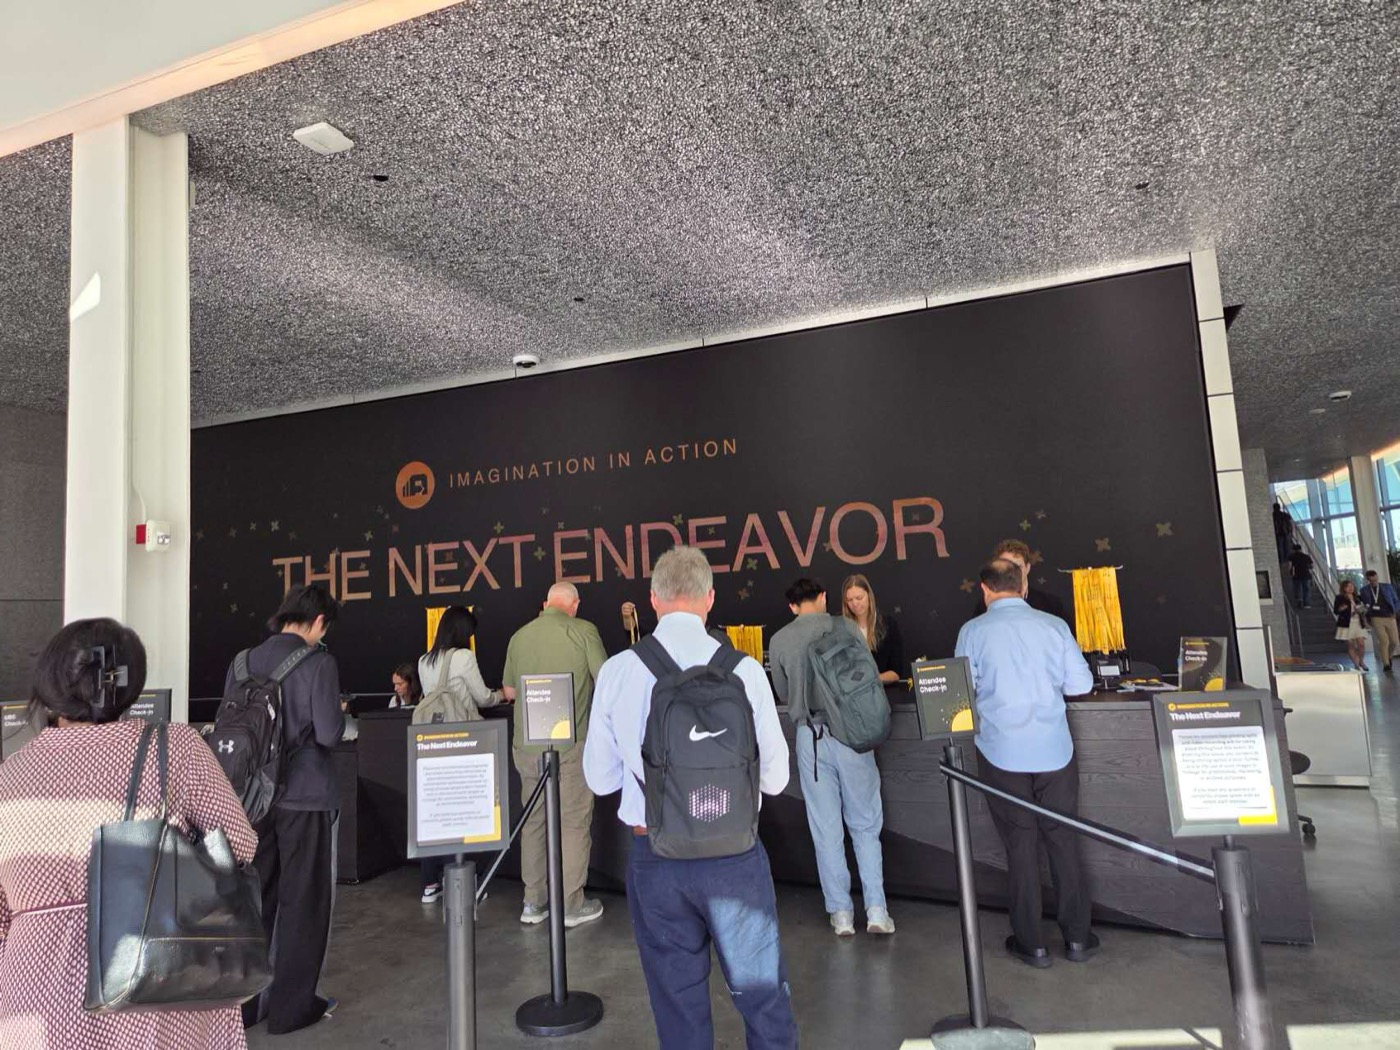
据 SVTR AI 创投库追踪,Cerebras 上市前在一级市场累计融资 29 亿美元,十年走完。2026 年 5 月 14 日它在纳斯达克上市,一次募到 55.5 亿美元,按发行价计完全稀释估值约 564 亿美元,超过 Arm 在 2023 年 48.7 亿美元的纪录,是 2026 年最大的 IPO。一级市场十年融到的钱,不及二级市场开盘那一天。
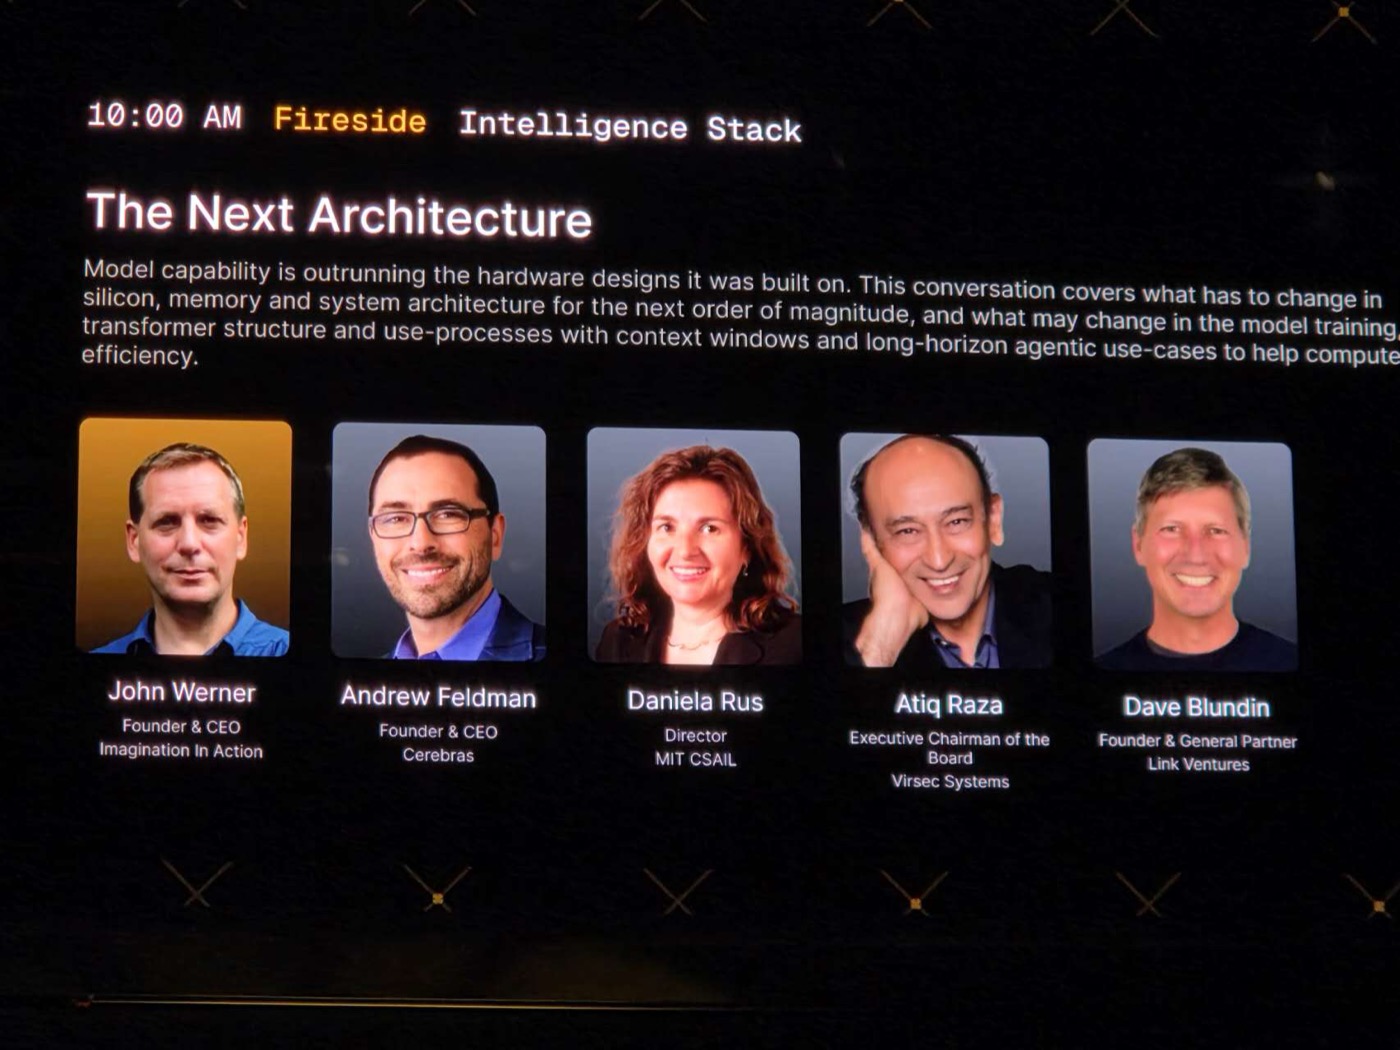
上午 10 点那场叫 The Next Architecture。主办方把一句话打在大屏上:Model capability is outrunning the hardware designs it was built on,模型能力正在跑赢它赖以构建的硬件设计。台上四个人,Cerebras 创始人兼 CEO Andrew Feldman、Virsec Systems 董事会执行主席 Atiq Raza、Link Ventures 创始合伙人 Dave Blundin 以及本次活动组织方 IIA 的 John Werner。
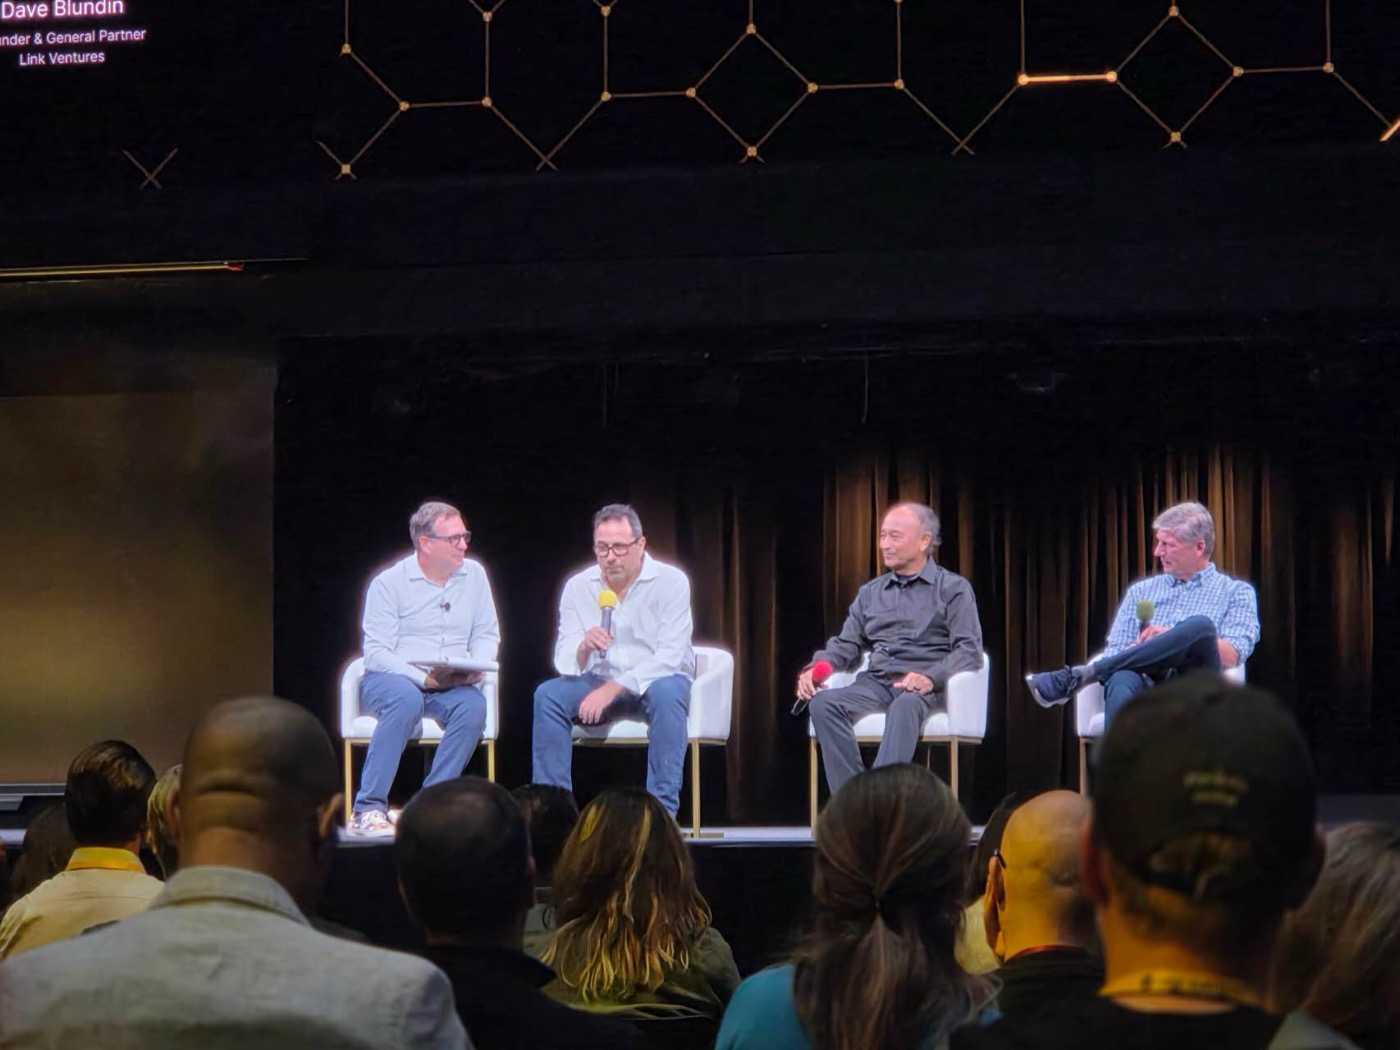
Feldman 把自己这十年总结成一句:长期错着,但别死掉。Cerebras 十年前押的是速度会成为关键,2020 年他们解决掉一个存在了 75 年的芯片架构问题,当时没人在意。要等到模型聪明到真正可用,这个赌注才算赢。
模型已经够聪明,现在拼的是快
Feldman 讲得直接,又笨又快没有用。速度在今天成为门槛,前提恰恰是模型已经够聪明,聪明不再是变量,延迟才是。
他举的例子都很具体。Netflix 如果下载速度上不去,就只能是个租碟公司,长不出一家绕过院线的流媒体工作室。写代码的 AI 助手要快到可以随时打断、随时接话,才谈得上有人用。个人助理帮你点一份卷饼要花 8 分钟,这功能就不成立。
律所和会计这类按时间计费的生意最说明问题。它们的最小计费单位是 6 分钟,在这 6 分钟里能不能跑完 30 倍的工作量,直接决定这门生意怎么定价。
速度过了某条线,改变的是这门生意还能不能换一种做法。
可是企业用不起来,卡住的都不是模型
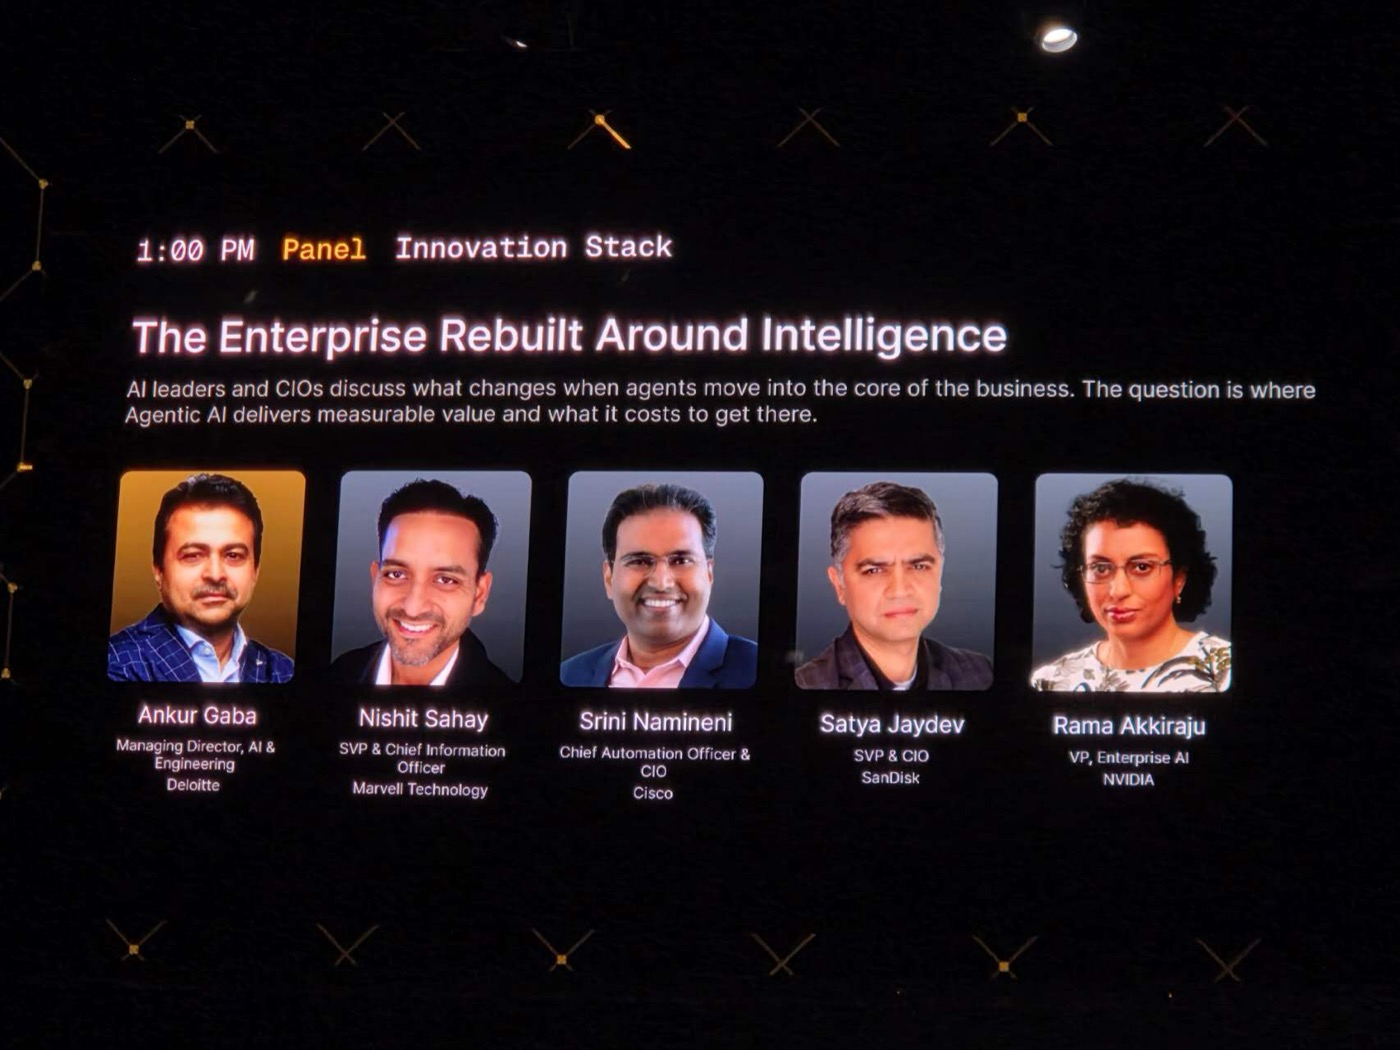
下午一点那场叫 The Enterprise Rebuilt Around Intelligence,台上五个人全是甲方,他们的问题和速度毫无关系。
NVIDIA 企业 AI 副总裁 Rama Akkiraju 说,芯片设计、供应链计划、IT 与网络安全、员工效率这四类应用在生产环境跑了一年半以上。Cisco 首席自动化官兼 CIO Srini Namineni 说收获最大的是软件开发流程,三周前刚给每一位员工上线个人智能体,接进 Outlook 和日历,不用吩咐就主动干活。闪迪(SanDisk)高级副总裁兼 CIO Satya Jaydev 分两条线走,一条做效率,一条做差异化,重心压在工程和制造,因为良率动一个点就是几百万美元。Marvell 高级副总裁兼 CIO Nishit Sahay 需要的是经营杠杆,公司要从 25 亿美元做到 125 亿美元以上,智能体哪里都能用,难的是决定先投哪里。
卡住他们的四件事,没有一件跟模型有关。
- 流程情报。要搞清楚活到底怎么干,假设往往和实际两回事。有公司一直盯着从下单到出货那条主线,后来发现卡住发货的是上游领料。
- 上下文工程。给数据建立起能被理解的语义关系,比拥有这些数据难得多。
- 身份与权限。智能体默认继承创建者的身份,连特权一起继承。这是眼下最大的未解风险。
- 数据地基。Satya Jaydev 的说法是垃圾进、垃圾出,还得平方。闪迪把整个架构分四层:数据地基、各类网关、语义层,最后才是用户碰得到的界面。
Cisco 那个例子最能说明价值在哪。这家公司做过 250 次收购,员工每天在几十个系统之间穿梭。智能体干的事不是让他们穿梭得更快,是让他们不必再穿梭。
花十分之一的钱,追到差不多的水平
如果聪明还是护城河,有件事解释不通:为什么用十分之一到百分之一的成本训出来的模型,性能能追到接近持平。
月之暗面 7 月发布的 Kimi K3 是个好样本。总参数 2.8 万亿,每个 token 只激活 1040 亿。93 层里 69 层用自研的 Kimi Delta Attention(一种更省的线性注意力机制),24 层用完整注意力,大约三比一交替。键值缓存(模型推理时暂存上下文用的那块显存,占用是大头)最多省掉 75%,100 万 token 长上下文下解码吞吐最高提升 6 倍。
容易读反的地方在这儿:K3 的厉害不在于它小。2.8 万亿参数一点都不小,它厉害在让每一个 token 变便宜。
出口管制反而逼出了量化技术的快速迭代。闭源前沿模型的领先大约只剩 4 到 8 个月,开源紧随其后。我们 7 月从梁文锋闭门谈话里提炼过同一个判断,开源本身就是一种成本策略。
据 SVTR AI 创投库,月之暗面累计融资 80 亿美元。
还在为聪明砸钱的,只剩那几家
能力商品化,和能力不重要,是两回事。
同一场会上有个反方向的事实:OpenAI 把 Cerebras 的全部推理产能优先给了自己的内部工程师,用来加速自家模型研发。对前沿实验室来说,多拿一份算力换更强的模型,回报还是高过卖给客户。
两套经济学同时在跑。少数几家前沿实验室仍在为能力本身付钱,也付得起;其余所有人买的是能力,而能力的采购价正在崩。
下午三点那场直接叫 Follow the Capital,换了个场地,绿植墙、吊灯、落地窗,和主舞台那个黑箱完全两个气氛。投资人在这里给了佐证:有基金说种子期看团队质量和 AI 原生程度就几乎够了,甚至报出零亏损的组合;有公司拿了 100 万美元种子轮,6 个月做到 1 亿美元 ARR。
这种回报形态不可能来自“我们的模型更聪明”,只可能来自“我们用很便宜的能力很快地交付了结果”。
现在算的是办成一件事花多少钱
衡量指标正在从每百万 token 多少钱,换成每达成一个结果多少钱。前沿模型准确率最高、单价也最高,开源模型和垂直领域模型往往以零头的价格做到接近的效果。
配套的做法是路由。我们在 8 月拆解 OpenRouter 时给过一句判断:路由正在成为能力,而不是品类。峰会上企业侧的做法给它补了成本口径,八成任务放在本地固定成本的算力池里跑,只把最难的两成交给前沿模型。
之所以可行,是因为一个常被忽略的不对称:企业任务的复杂度,并没有跟着模型能力一起变难。
只要路由架构搭对,同一件事的单位成本应该逐年下降。搭不对的公司正好相反,模型越强,账单越高。这条线会在未来几个季度把 AI 应用公司的毛利结构撕开。
账单涨得比谁预想的都快。token 支出以三位数百分比同比增长。Cisco 内部调查显示员工每周省下的时间从 3 到 4 小时涨到 7.6 小时,工程岗超过 10 小时,用得越多,账单越厚。
真正难抄的是数据,和造东西的本事
能力层留不住价值,价值去了哪里。这个问题我们在 6 月的 AWS 中国峰会现场追过一次,当时卖云的亚马逊自己在主舞台上把模型踢出了护城河,把数据摆了上来。这次峰会给出两个更具体的方向。
一个是专有数据。投资人的共识是,制药和生物领域的专有数据集,比算法优势或编排能力更耐久。Otter.ai 是现成的例子。创始人 Sam Liang 十年前的想法很朴素,Gmail 可以搜索,说过的话却找不回来。这家公司自建语音识别和说话人识别,没有用第三方接口,如今 3500 万用户、1 亿美元 ARR,不到 200 人,人均创收超过 50 万美元。
Otter 的经历还给本文主线添了一个注脚。Zoom 的转写系统最初由 Otter 承建,2017 年到 2023 年一直如此,Zoom 上市之后停止授权,改为自建。能力一旦可以内部化,授权方就会被甩掉。Otter 现在往会话知识引擎的方向走,把语音当作比客户关系系统、文档和数据库更大的商业情报来源,建人、项目、客户之间的知识图谱。
另一个方向更硬,是物理世界的交付能力,而这恰恰又是中国的优势。
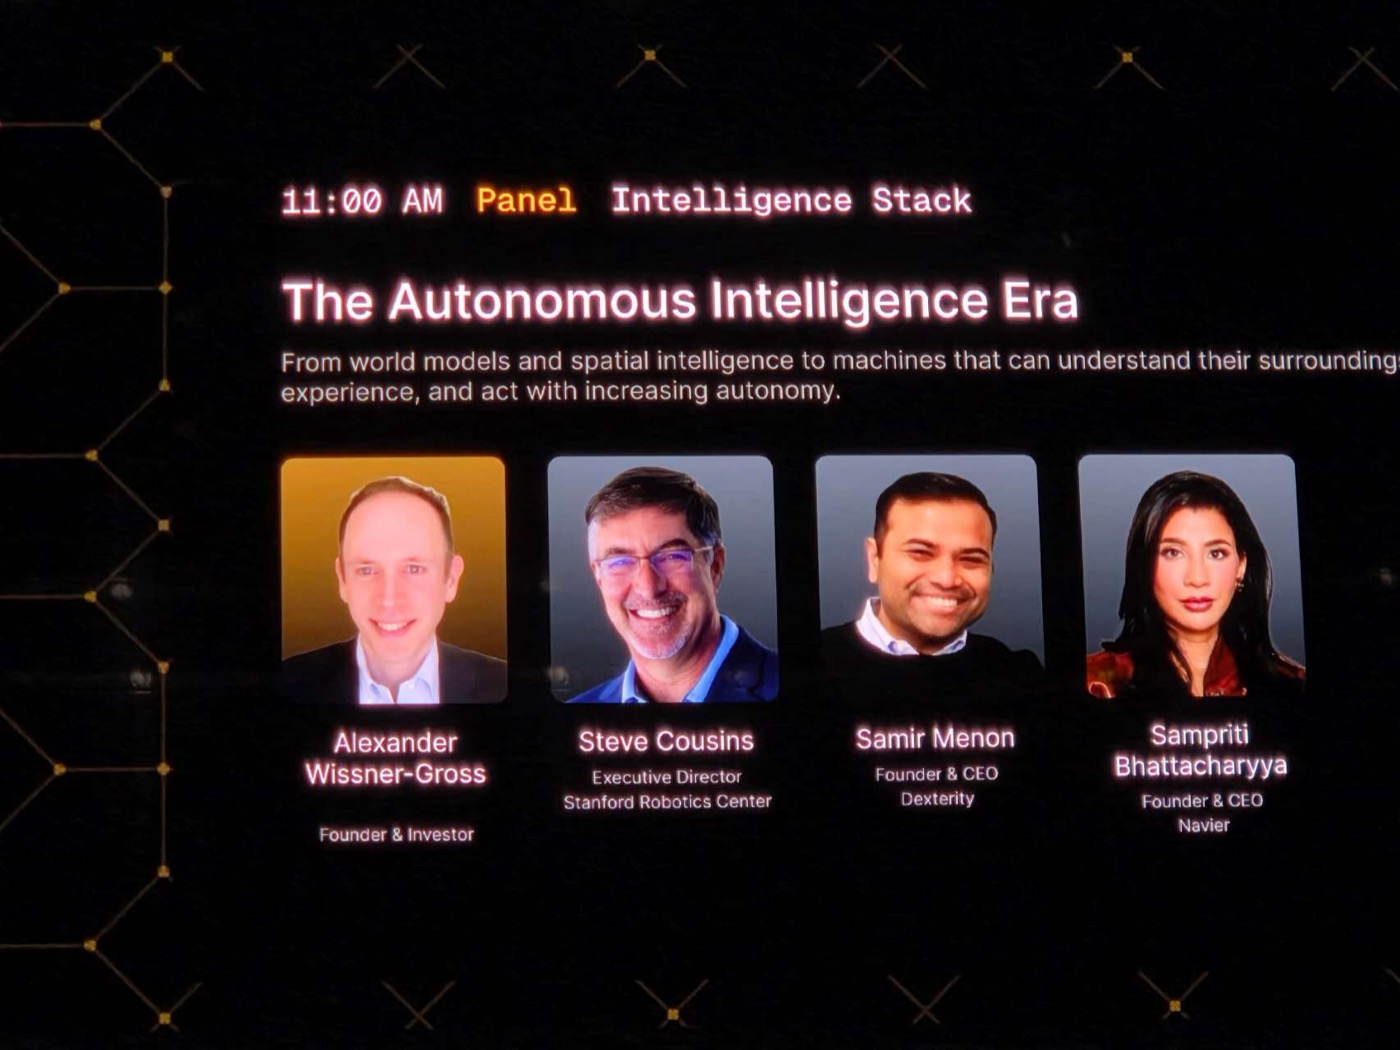
上午 11 点那场 The Autonomous Intelligence Era 讨论机器人,结论是通用人形机器人被高估了。Stanford Robotics Center 执行主任 Steve Cousins 的说法是,工作空间决定机器人的形态,所谓跨越所有工作空间的通用,本身没有定义。Waymo、扫地机器人、自主船舶都不是人形,也都很有用;显微手术机器人需要专门设计的形态,人的手指帮不上忙。台上有人提了个很具体的测试,拆开一盒五岁孩子的乐高,照说明书装完。今天没有任何机器人做得到,现场给的估计是还要 5 到 10 年。
值得注意的是供应链那句:美国没有可信的执行器厂商,中国在工业机器人和相关供应链上遥遥领先。
生物医药那边也是如此。AI 设计的药物,失败率和传统药物一样。难点在于读懂生物学,分子设计本身早已够用。按现场给出的数字,约四分之一的一期临床试验如今来自中国,成本低 30% 到 60%。
我们的判断
人工智能正在变成基础设施,成本一路向下。真正稀缺的是在给定成本下把结果交付出去的能力,它落在路由架构、专有数据和物理供应链上。
对早期投资人,我们的建议是把尽调里那道“你们模型多强”的题,换成“你们每达成一个结果花多少钱,这个数字过去三个季度是涨是跌”。答不上来的公司,模型越强越危险。
这个判断来自一天的会议观察,加上我们对相关公司的逐笔追踪。好几个互不相干的信号同时指向它,但还不足以说产业结构已经变了。接下来有几件事可以拿来验证:企业侧公布的单任务成本是否真的逐年下降;开源模型与前沿模型的差距会不会重新拉开;美国的执行器供应链有没有出现可信玩家。
这两天的完整现场记录收在《SVTR 现场笔记:IIA 硅谷 AI 峰会两天全记录》,1.4 万字,含本文没写的五块(地缘政治、资本流向、AI 做科学、未来工作与教育、Google Research),以及两天完整议程索引与我们改掉的转写错误。
如果稀缺的是交付,把产品带到客户和产业伙伴面前,就比再调一版参数更有价值。SVTR 2027 春季全球创投营:CES × 硅谷,面向全球 AI 与硬科技初创企业招募 15 家,2027 年 1 月去拉斯维加斯和硅谷,目标就是找客户、产业伙伴和资本合作。
商务合作,请联系侯经理 18801065284(微信同号)
报料及内容合作,请联系chanlianshe2026(微信号)
特别声明:本文仅供参考,不构成任何投资建议,未经允许不得转载。